Jev: qué es la nueva IA de TypeSafe y para qué sirve
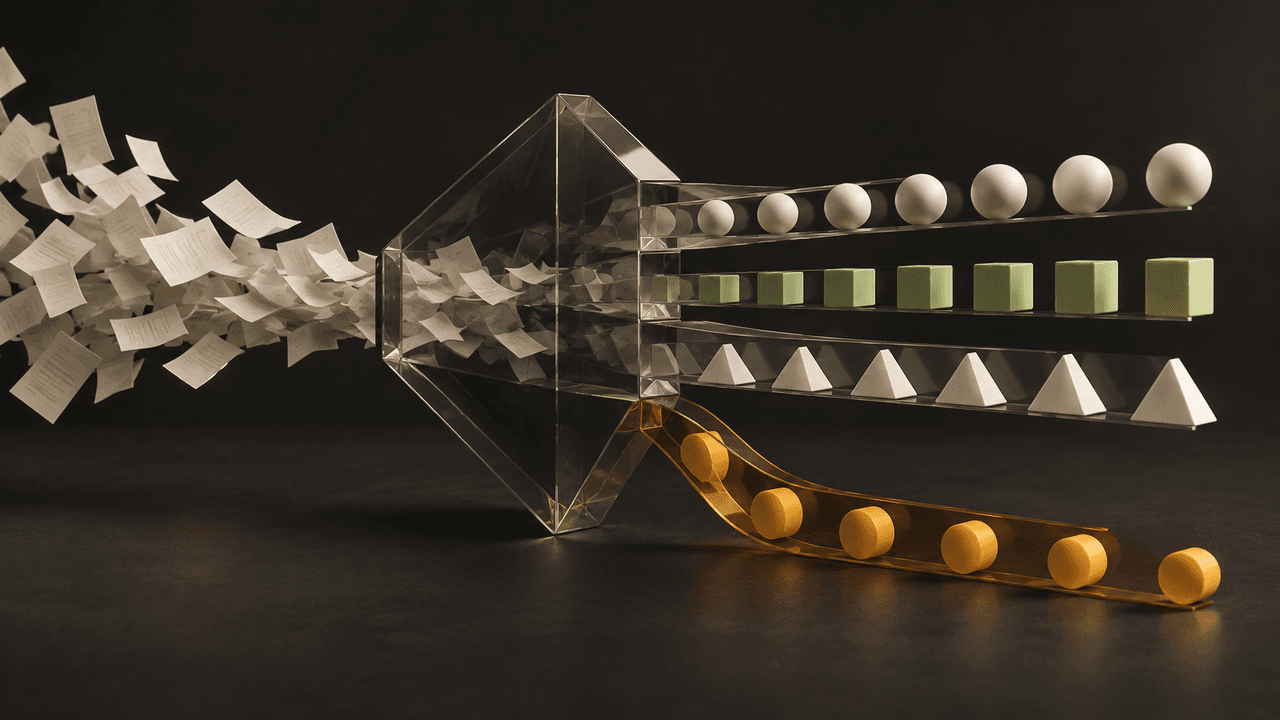
Cada consulta que llega a una empresa obliga a decidir algo: quién la atiende, qué prioridad tiene o si hace falta pedir más información. Jev apunta precisamente a ese trabajo que ocurre entre recibir un mensaje y actuar.
Jev es un modelo de IA de TypeSafe que evalúa información y devuelve decisiones estructuradas: una opción, una puntuación o una probabilidad. Se integra en aplicaciones para que estas puedan clasificar y encaminar tareas. TypeSafe lo denomina un modelo System One. Su utilidad está en resolver preguntas acotadas dentro de un proceso. Introducción oficial.
Información comprobada el 20 de septiembre de 2026. Este artículo analiza documentación pública; no hemos realizado una prueba propia de la API ni medido su rendimiento en proyectos de Aimoova.
Qué ha presentado TypeSafe
TypeSafe anunció el acceso anticipado a Jev el 15 de septiembre de 2026. Diogo Almeida, fundador de la compañía y antiguo investigador de OpenAI, explica que el proyecto nace de una pregunta: cómo llevar la inteligencia de los modelos al software que ejecuta trabajo cotidiano. La empresa presenta un entrenamiento llamado RLCD, orientado a decisiones con probabilidades calibradas. Anuncio de lanzamiento.
Para una pyme, la cuestión práctica es dónde encaja. Si una persona revisa cada correo para decidir si corresponde a ventas, soporte o administración, hay una tarea concreta que estudiar. Si necesitas redactar una propuesta completa, buscas otra capacidad.
Cómo funciona Jev, explicado sin complicaciones
La aplicación envía el contexto disponible y las preguntas que necesita resolver. Define también las respuestas permitidas o los criterios de evaluación. Jev devuelve valores que el programa puede utilizar directamente, sin tener que interpretar un párrafo de respuesta.
Su documentación distingue tres tipos de pregunta:
| Tipo | Qué devuelve | Ejemplo ilustrativo de uso |
|---|---|---|
| Choice | Una opción entre las definidas, sus probabilidades y una medida de confianza | Elegir entre ventas, soporte, administración u otros |
| Score | Una puntuación sobre niveles descritos, probabilidades y confianza | Valorar la urgencia de una incidencia según una escala |
| Noul | Un valor entre 0 y 1 que representa la probabilidad de que la respuesta sea afirmativa | Evaluar si un mensaje solicita una llamada |
Las definiciones están en las páginas oficiales de Choice, Score y Noul. Los ejemplos de la tabla son nuestros, no resultados obtenidos con Jev.
Hay un matiz útil: confianza y probabilidad no son sinónimos. En Choice y Score, la confianza se calcula a partir de cómo se distribuyen las probabilidades. No debe interpretarse automáticamente como un porcentaje garantizado de acierto. Noul no devuelve ese campo separado. Documentación de confianza.
Jev, un modelo generativo o una regla: qué usar en cada caso
Nuestra propuesta para elegir es empezar por la salida que necesita el proceso:
| Necesidad | Punto de partida que evaluaríamos |
|---|---|
| Saber si un importe supera un límite definido | Una regla de software |
| Interpretar el motivo de una consulta escrita de muchas formas | Jev u otro clasificador, comparados con ejemplos reales |
| Redactar una respuesta adaptada al cliente | Un modelo generativo con información verificada |
| Resolver una excepción comercial delicada | Una persona con contexto y autoridad para decidir |
La separación importa porque una automatización suele mezclar esas tareas. El modelo puede sugerir el departamento; el programa asigna la consulta; el equipo resuelve la excepción. Cada paso necesita un responsable y una condición de salida clara.
Es la misma lógica que explicamos al diseñar automatizaciones con IA para empresas: entender primero qué parte del trabajo es mecánica y qué parte exige interpretar información.
Cuánto cuesta Jev
La ficha oficial de Jev 1.13 publica 0,042 dólares por millón de tokens de entrada, con salida gratuita. Los tokens son unidades de texto que procesa el modelo; no equivalen a un número fijo de mensajes. El importe es una tarifa de uso del modelo, no el precio de implantar una solución. Modelos y precios de TypeSafe.
Ejemplo de cálculo, no presupuesto ni consumo medido: si cada evaluación utilizase 1.000 tokens facturables de entrada, 100.000 evaluaciones sumarían 100 millones de tokens. A esa tarifa, el uso del modelo costaría 4,20 dólares. El tamaño real incluye el contexto y las preguntas de cada petición.
Para valorar el proyecto faltaría sumar integración, herramientas intermedias, mantenimiento y revisión de errores. Una API barata no convierte por sí sola un proceso mal definido en una inversión rentable.
Qué significan las cifras de velocidad
TypeSafe anuncia tiempos de respuesta de 70 a 500 milisegundos. También comunica mejoras de hasta 193,6 veces en velocidad y 444,6 veces en coste en sus evaluaciones de flujos de trabajo. Son resultados del proveedor; la propia compañía advierte que los multiplicadores están en la zona alta de las mejoras que espera en usos reales y que sus mediciones se hicieron generalmente desde la costa oeste de Estados Unidos. Resultados y matices del lanzamiento.
La metodología compara cuatro flujos con respuestas de referencia generadas a partir de otros modelos. Es información útil para entender el experimento, pero no equivale a medir la precisión con consultas de tus clientes. Metodología de evaluación.
Nuestra lectura: para una empresa española, el dato decisivo sería el tiempo completo desde que entra una consulta hasta que llega al destino correcto, incluyendo conexiones, reintentos y excepciones.
Formato correcto no significa decisión correcta
Una respuesta puede pertenecer a una categoría válida y estar equivocada. Si el sistema permite elegir entre «ventas» y «soporte», devolver «ventas» cumple el formato aunque el mensaje describa una avería.
Por eso conviene leer las promesas de ausencia de alucinaciones junto con las limitaciones que TypeSafe publica para Jev 1.13. La compañía reconoce dificultades con cálculos, fechas, instrucciones indirectas, contexto irrelevante y contenido diseñado para influir en la clasificación. Recomienda mantener la aritmética en código y probar casos difíciles. Limitaciones oficiales.
En español también hace falta comprobar el resultado: TypeSafe indica que el inglés es el idioma principal de entrenamiento y donde obtiene mejor precisión. La versión documentada admite texto, no imágenes, audio o vídeo directamente. Ficha del modelo e idiomas.
Tres aplicaciones que tendría sentido probar en una pyme
Los siguientes escenarios son ilustrativos. No describen implantaciones de Aimoova ni prometen resultados.
Distribuir consultas sin convertir cada mensaje en una tarea manual
Imagina una empresa que recibe solicitudes de presupuesto, incidencias y consultas de facturación en el mismo buzón. Un piloto podría comparar la clasificación propuesta por Jev con la asignación del equipo.
Empezaríamos con una sugerencia visible para la persona que ya atiende el buzón. Registraríamos las correcciones y los mensajes que mezclan varios temas. Solo después tendría sentido decidir qué categorías pueden asignarse automáticamente.
Ordenar oportunidades comerciales con criterios explícitos
En una bandeja de leads, «parece interesante» es una instrucción demasiado vaga. Resultaría más útil separar preguntas: ¿describe una necesidad concreta?, ¿pide una reunión?, ¿indica cuándo quiere empezar?
La prioridad final debería depender de reglas comerciales acordadas. Un contacto con poca información podría necesitar una pregunta adicional, en lugar de recibir una puntuación baja y desaparecer del seguimiento. También convendría comprobar si el sistema interpreta bien mensajes breves, faltas de ortografía y expresiones propias del sector.
Preparar el siguiente paso de un asistente
En un chatbot para ecommerce, una clasificación puede ayudar a distinguir una duda de producto de una incidencia de pedido. Después, otra pieza consulta la información correspondiente y redacta la respuesta.
El alcance del piloto sería decidir la ruta. No conceder descuentos ni aprobar devoluciones por una puntuación aislada. Para evaluar su utilidad, revisaríamos cuántas conversaciones llegan al equipo correcto y cuántas tienen que volver atrás.
Cómo probarlo con criterio
Este sería nuestro planteamiento de evaluación, no un resultado ya demostrado:
- Escoge una decisión repetida. Por ejemplo, asignar consultas a un departamento. Define también qué significa «no se puede decidir».
- Prepara ejemplos representativos. Incluye consultas claras, ambiguas y casos que el equipo suele resolver con dificultad. Separa los ejemplos usados para ajustar instrucciones de los usados para evaluar.
- Compara alternativas. Mide Jev frente al proceso actual, una regla sencilla cuando sea viable y el modelo que ya utilices. Mantén el mismo criterio de acierto.
- Observa el coste del error. No pesa igual retrasar una consulta general que ocultar una incidencia urgente. Cuenta ambas cosas por separado.
- Prueba sin ejecutar acciones. Deja que el sistema proponga decisiones mientras el equipo sigue trabajando. Examina los desacuerdos antes de automatizar.
- Decide cómo mantenerlo. Asigna quién revisa excepciones, qué cambios obligan a repetir la evaluación y cómo se vuelve al procedimiento anterior.
También necesitas información pertinente y actualizada. En el artículo sobre contexto para agentes de IA desarrollamos ese problema: el modelo solo es una parte del sistema que toma la decisión.
Si todavía no está claro qué proceso merece esa prueba, una consultoría de IA debería ayudarte a concretarlo antes de elegir proveedor.
Cómo se puede acceder
TypeSafe ofrece una consola con Playground y acceso por API. Su guía muestra cómo enviar contexto y preguntas al endpoint del servicio. Primeros pasos oficiales.
Además, Vercel anunció la disponibilidad de Jev en AI Gateway el 16 de septiembre de 2026, mediante su interfaz experimental de evaluación. Es una vía de integración documentada; las condiciones, cuotas y disponibilidad deben comprobarse en la cuenta que vaya a utilizarlo. Anuncio de Vercel.
Preguntas frecuentes
¿Jev sustituye a ChatGPT?
Su función documentada es devolver decisiones acotadas. Para redactar, resumir o mantener una conversación abierta seguirás necesitando una herramienta generativa. Ambos tipos de modelo pueden formar parte del mismo proceso.
¿Se puede usar Jev en español?
Puede recibir texto en español, pero TypeSafe no afirma que su precisión sea equivalente a la del inglés. Antes de automatizar, evalúa tus propios mensajes y terminología. Idiomas admitidos.
¿Jev se equivoca?
Sí. Respetar el formato de salida no garantiza acertar en el significado. La documentación incluye fallos conocidos; conviene conservar una ruta de revisión para los casos dudosos.
¿Cuánto costaría integrarlo en mi empresa?
La tarifa del modelo permite estimar una parte del consumo. El presupuesto completo depende del proceso, los sistemas que haya que conectar, las pruebas y el mantenimiento. Primero define qué decisión quieres mejorar y cómo vas a medirlo.
Fuentes primarias: documentación y anuncio de TypeSafe AI, su portal de evaluaciones y el anuncio de disponibilidad de Vercel, enlazados junto a cada dato. Los ejemplos y el plan de prueba son propuestas ilustrativas de este artículo.
Empieza por el Diagnóstico de IA gratuito para identificar qué decisiones repetidas merece la pena estudiar en tu empresa.